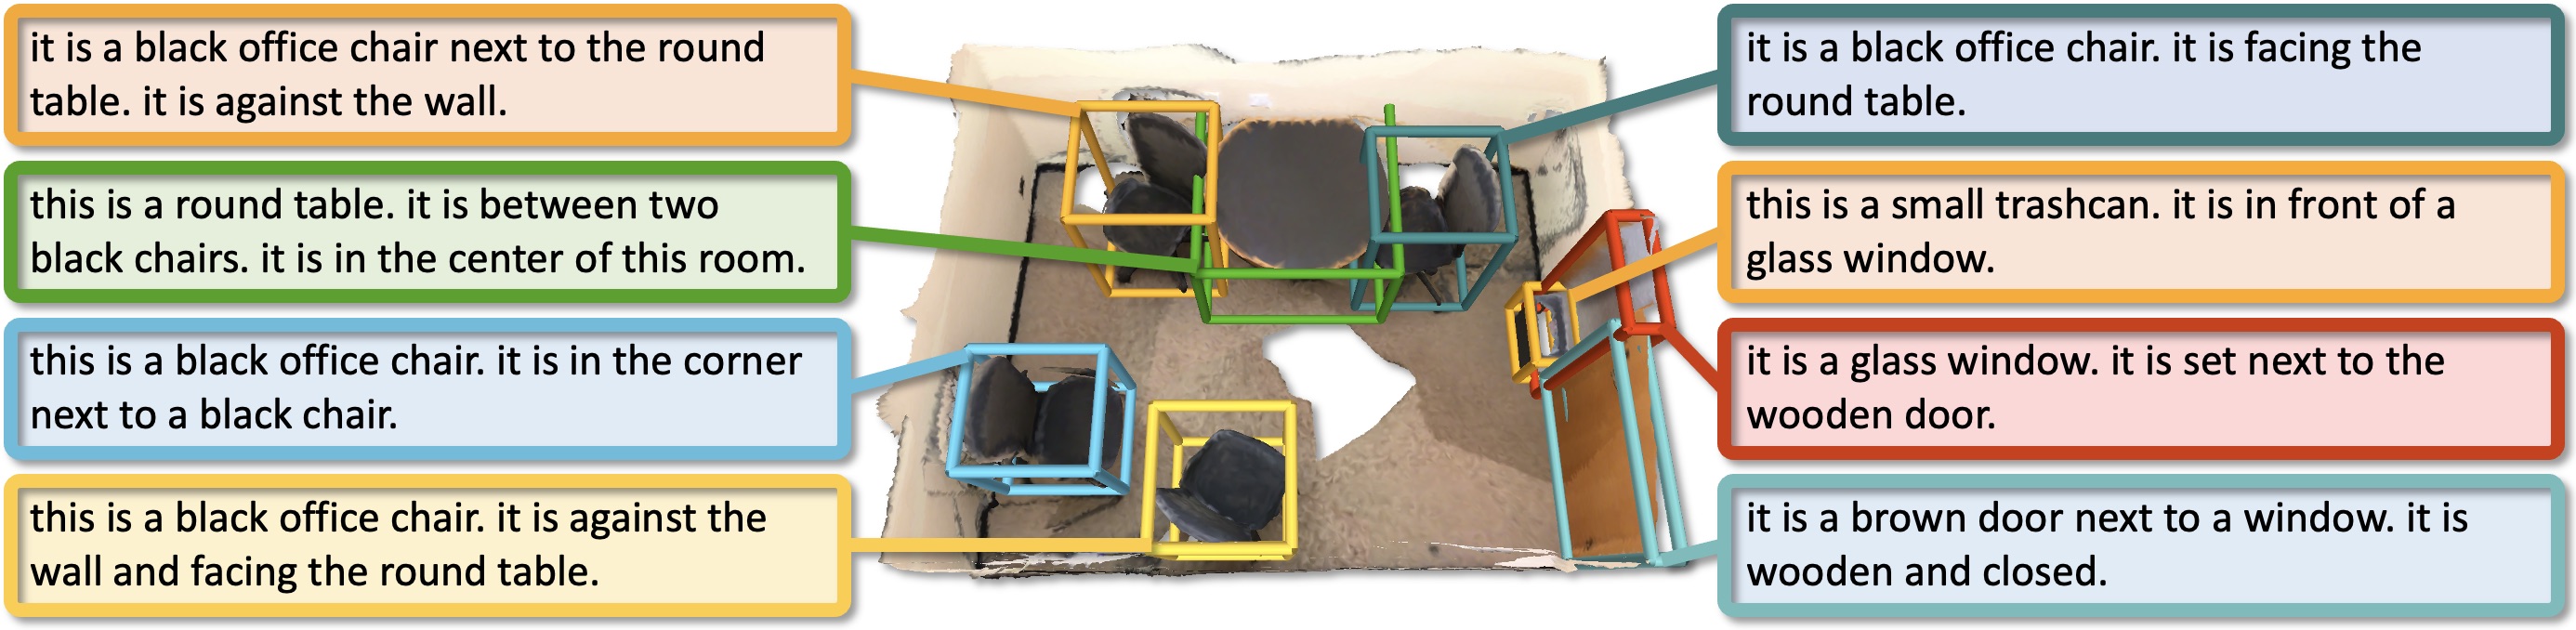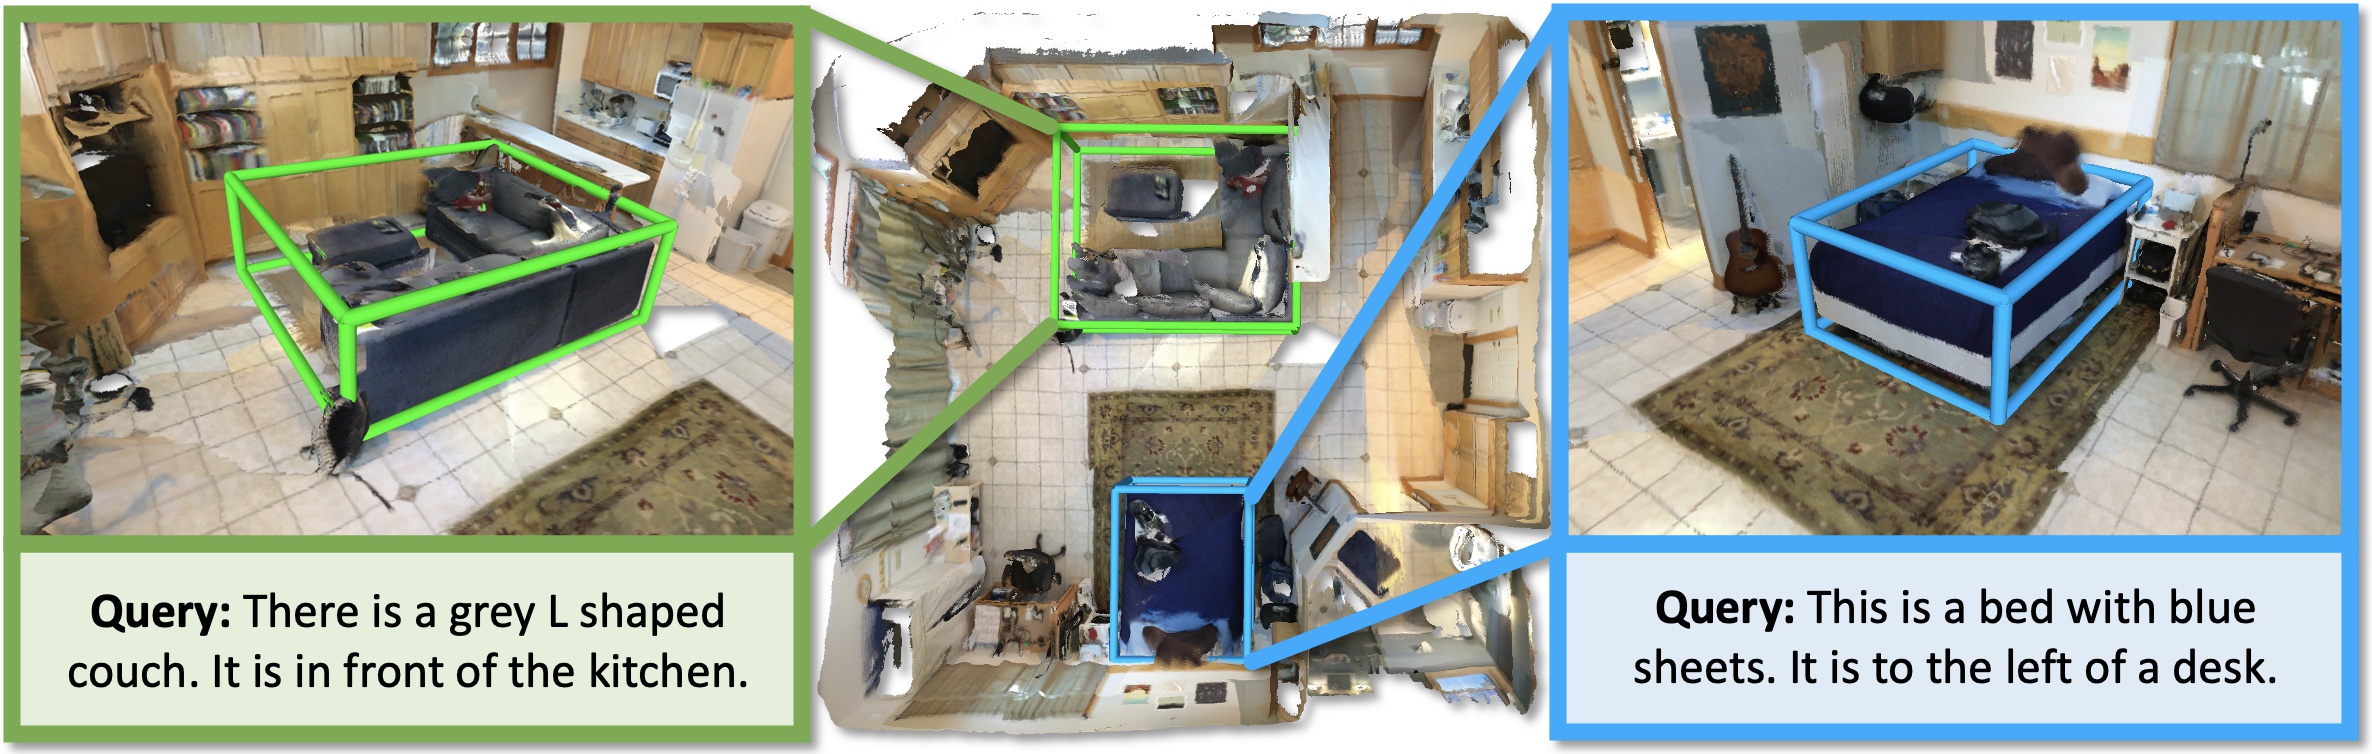
ScanRefer Benchmark
This table lists the benchmark results for the ScanRefer Localization Benchmark scenario.
| Unique | Unique | Multiple | Multiple | Overall | Overall | ||
|---|---|---|---|---|---|---|---|
| Method | Info | acc@0.25IoU | acc@0.5IoU | acc@0.25IoU | acc@0.5IoU | acc@0.25IoU | acc@0.5IoU |
 | | | | |  | ||
| Holi2D-3DRS V31 | 0.8895 1 | 0.8203 2 | 0.5990 1 | 0.5225 1 | 0.6641 1 | 0.5893 1 | |
| UniVLG |  | 0.8895 1 | 0.8236 1 | 0.5921 2 | 0.5030 2 | 0.6588 2 | 0.5749 2 |
| Ayush Jain, Alexander Swerdlow, Yuzhou Wang, Alexander Sax, Franziska Meier, Katerina Fragkiadaki: Unifying 2D and 3D Vision-Language Understanding. | |||||||
| Chat-Scene | | 0.8887 3 | 0.8005 3 | 0.5421 3 | 0.4861 3 | 0.6198 3 | 0.5566 3 |
| Haifeng Huang, Yilun Chen, Zehan Wang, et al.: Chat-Scene: Bridging 3D Scene and Large Language Models with Object Identifiers. NeurIPS 2024 | |||||||
| ConcreteNet | 0.8607 4 | 0.7923 4 | 0.4746 10 | 0.4091 4 | 0.5612 9 | 0.4950 4 | |
| Ozan Unal, Christos Sakaridis, Suman Saha, Luc Van Gool: Four Ways to Improve Verbo-visual Fusion for Dense 3D Visual Grounding. ECCV 2024 | |||||||
| cus3d | 0.8384 6 | 0.7073 8 | 0.4908 8 | 0.4000 5 | 0.5688 7 | 0.4689 5 | |
| D-LISA | 0.8195 8 | 0.6900 10 | 0.4975 6 | 0.3967 7 | 0.5697 6 | 0.4625 6 | |
| Haomeng Zhang, Chiao-An Yang, Raymond A. Yeh: Multi-Object 3D Grounding with Dynamic Modules and Language-Informed Spatial Attention. NeurIPS 2024 | |||||||
| M3DRef-test | 0.7865 24 | 0.6793 16 | 0.4963 7 | 0.3977 6 | 0.5614 8 | 0.4608 7 | |
| pointclip | 0.8211 7 | 0.7082 7 | 0.4803 9 | 0.3884 8 | 0.5567 10 | 0.4601 8 | |
| M3DRef-SCLIP | 0.7997 15 | 0.7123 5 | 0.4708 11 | 0.3805 11 | 0.5445 11 | 0.4549 9 | |
| M3DRef-CLIP | | 0.7980 16 | 0.7085 6 | 0.4692 12 | 0.3807 10 | 0.5433 12 | 0.4545 10 |
| Yiming Zhang, ZeMing Gong, Angel X. Chang: Multi3DRefer: Grounding Text Description to Multiple 3D Objects. ICCV 2023 | |||||||
| CORE-3DVG | 0.8557 5 | 0.6867 11 | 0.5275 4 | 0.3850 9 | 0.6011 4 | 0.4527 11 | |
| 3DInsVG | 0.8170 9 | 0.6925 9 | 0.4582 17 | 0.3617 12 | 0.5386 15 | 0.4359 12 | |
| RG-SAN | 0.7964 17 | 0.6785 17 | 0.4591 16 | 0.3600 13 | 0.5348 18 | 0.4314 13 | |
| 3DVLP-rf-enhance | 0.7939 20 | 0.6546 22 | 0.4651 13 | 0.3491 14 | 0.5388 14 | 0.4176 14 | |
| 3DVLP-rf | 0.7964 17 | 0.6579 20 | 0.4646 14 | 0.3436 16 | 0.5390 13 | 0.4140 15 | |
| 3DVLP-baseline | 0.7766 36 | 0.6373 25 | 0.4572 19 | 0.3469 15 | 0.5288 25 | 0.4120 16 | |
| 3dvlp-with-judge | 0.7807 32 | 0.6472 23 | 0.4498 28 | 0.3407 17 | 0.5240 28 | 0.4094 17 | |
| Jung | 0.8096 12 | 0.6331 27 | 0.5113 5 | 0.3398 19 | 0.5782 5 | 0.4055 18 | |
| ScanRefer-3dvlp-test | 0.7824 30 | 0.6298 28 | 0.4532 26 | 0.3405 18 | 0.5270 27 | 0.4054 19 | |
| HAM | 0.7799 33 | 0.6373 25 | 0.4148 36 | 0.3324 21 | 0.4967 36 | 0.4007 20 | |
| Jiaming Chen, Weixin Luo, Ran Song, Xiaolin Wei, Lin Ma, Wei Zhang: Learning Point-Language Hierarchical Alignment for 3D Visual Grounding. | |||||||
| CSA-M3LM | 0.8137 10 | 0.6241 29 | 0.4544 24 | 0.3317 22 | 0.5349 17 | 0.3972 21 | |
| 3dvlp-judge-h | 0.7552 46 | 0.6051 32 | 0.4458 30 | 0.3340 20 | 0.5152 30 | 0.3948 22 | |
| D3Net | | 0.7923 22 | 0.6843 12 | 0.3905 40 | 0.3074 34 | 0.4806 39 | 0.3919 23 |
| Dave Zhenyu Chen, Qirui Wu, Matthias Niessner, Angel X. Chang: D3Net: A Unified Speaker-Listener Architecture for 3D Dense Captioning and Visual Grounding. 17th European Conference on Computer Vision (ECCV), 2022 | |||||||
| GALA-Grounder-D3 | 0.7939 20 | 0.5952 34 | 0.4625 15 | 0.3229 24 | 0.5368 16 | 0.3839 24 | |
| LAG-3D-2 | 0.7964 17 | 0.5812 40 | 0.4572 19 | 0.3245 23 | 0.5333 19 | 0.3821 25 | |
| ContraRefer | 0.7832 28 | 0.6801 15 | 0.3850 41 | 0.2947 36 | 0.4743 40 | 0.3811 26 | |
| LAG-3D-3 | 0.7815 31 | 0.5837 38 | 0.4556 22 | 0.3219 25 | 0.5287 26 | 0.3806 27 | |
| Graph-VG-2 | 0.8021 14 | 0.5829 39 | 0.4546 23 | 0.3217 26 | 0.5325 20 | 0.3802 28 | |
| Clip | 0.7733 39 | 0.6810 14 | 0.3619 54 | 0.2919 41 | 0.4542 48 | 0.3791 29 | |
| Clip-pre | 0.7766 36 | 0.6843 12 | 0.3617 56 | 0.2904 42 | 0.4547 47 | 0.3787 30 | |
| 3DJCG(Grounding) | | 0.7675 43 | 0.6059 31 | 0.4389 31 | 0.3117 32 | 0.5126 31 | 0.3776 31 |
| Daigang Cai, Lichen Zhao, Jing Zhang†, Lu Sheng, Dong Xu: 3DJCG: A Unified Framework for Joint Dense Captioning and Visual Grounding on 3D Point Clouds. CVPR2022 Oral | |||||||
| Graph-VG-3 | 0.8038 13 | 0.5812 40 | 0.4515 27 | 0.3169 28 | 0.5305 22 | 0.3762 32 | |
| GALA-Grounder-D1 | 0.8104 11 | 0.5754 43 | 0.4479 29 | 0.3176 27 | 0.5292 24 | 0.3754 33 | |
| Graph-VG-4 | 0.7848 26 | 0.5631 46 | 0.4560 21 | 0.3164 30 | 0.5298 23 | 0.3717 34 | |
| LAG-3D | 0.7881 23 | 0.5606 47 | 0.4579 18 | 0.3169 28 | 0.5320 21 | 0.3715 35 | |
| 3DVG-Trans + | | 0.7733 39 | 0.5787 42 | 0.4370 32 | 0.3102 33 | 0.5124 32 | 0.3704 36 |
| Lichen Zhao∗, Daigang Cai∗, Lu Sheng†, Dong Xu: 3DVG-Transformer: Relation Modeling for Visual Grounding on Point Clouds. ICCV2021 | |||||||
| bo3d-1 | 0.7469 50 | 0.5606 47 | 0.4539 25 | 0.3124 31 | 0.5196 29 | 0.3680 37 | |
| Se2d | 0.7799 33 | 0.6628 19 | 0.3636 51 | 0.2823 44 | 0.4569 44 | 0.3677 38 | |
| secg | 0.7288 54 | 0.6175 30 | 0.3696 49 | 0.2933 38 | 0.4501 51 | 0.3660 39 | |
| SAF | 0.6348 62 | 0.5647 45 | 0.3726 47 | 0.3009 35 | 0.4314 55 | 0.3601 40 | |
| FE-3DGQA | 0.7857 25 | 0.5862 37 | 0.4317 33 | 0.2935 37 | 0.5111 33 | 0.3592 41 | |
| D3Net - Pretrained | | 0.7659 44 | 0.6579 20 | 0.3619 54 | 0.2726 45 | 0.4525 50 | 0.3590 42 |
| Dave Zhenyu Chen, Qirui Wu, Matthias Niessner, Angel X. Chang: D3Net: A Unified Speaker-Listener Architecture for 3D Dense Captioning and Visual Grounding. 17th European Conference on Computer Vision (ECCV), 2022 | |||||||
| HGT | 0.7692 42 | 0.5886 36 | 0.4141 37 | 0.2924 40 | 0.4937 37 | 0.3588 43 | |
| InstanceRefer | | 0.7782 35 | 0.6669 18 | 0.3457 60 | 0.2688 47 | 0.4427 53 | 0.3580 44 |
| Zhihao Yuan, Xu Yan, Yinghong Liao, Ruimao Zhang, Zhen Li*, Shuguang Cui: InstanceRefer: Cooperative Holistic Understanding for Visual Grounding on Point Clouds through Instance Multi-level Contextual Referring. ICCV 2021 | |||||||
| 3DVG-Transformer | | 0.7576 45 | 0.5515 50 | 0.4224 35 | 0.2933 38 | 0.4976 35 | 0.3512 45 |
| Lichen Zhao∗, Daigang Cai∗, Lu Sheng†, Dong Xu: 3DVG-Transformer: Relation Modeling for Visual Grounding on Point Clouds. ICCV2021 | |||||||
| SAVG | 0.7758 38 | 0.5664 44 | 0.4236 34 | 0.2826 43 | 0.5026 34 | 0.3462 46 | |
| PointGroup_MCAN | 0.7510 47 | 0.6397 24 | 0.3271 63 | 0.2535 49 | 0.4222 57 | 0.3401 47 | |
| TransformerVG | 0.7502 48 | 0.5977 33 | 0.3712 48 | 0.2628 48 | 0.4562 46 | 0.3379 48 | |
| TFVG3D ++ | | 0.7453 51 | 0.5458 54 | 0.3793 45 | 0.2690 46 | 0.4614 42 | 0.3311 49 |
| Ali Solgi, Mehdi Ezoji: A Transformer-based Framework for Visual Grounding on 3D Point Clouds. AISP 2024 | |||||||
| TGNN | 0.6834 59 | 0.5894 35 | 0.3312 61 | 0.2526 50 | 0.4102 61 | 0.3281 50 | |
| Pin-Hao Huang, Han-Hung Lee, Hwann-Tzong Chen, Tyng-Luh Liu: Text-Guided Graph Neural Network for Referring 3D Instance Segmentation. AAAI 2021 | |||||||
| BEAUTY-DETR |  | 0.7848 26 | 0.5499 51 | 0.3934 39 | 0.2480 51 | 0.4811 38 | 0.3157 51 |
| Ayush Jain, Nikolaos Gkanatsios, Ishita Mediratta, Katerina Fragkiadaki: Looking Outside the Box to Ground Language in 3D Scenes. | |||||||
| grounding | 0.7298 53 | 0.5458 53 | 0.3822 43 | 0.2421 53 | 0.4538 49 | 0.3046 52 | |
| henet | 0.7110 55 | 0.5180 56 | 0.3936 38 | 0.2472 52 | 0.4590 43 | 0.3030 53 | |
| scanrefer-rj-14bz | 0.7832 28 | 0.5524 49 | 0.3746 46 | 0.2275 54 | 0.4662 41 | 0.3004 54 | |
| scanrefer-test-14bz | 0.7700 41 | 0.5474 52 | 0.3665 50 | 0.2247 55 | 0.4569 44 | 0.2970 55 | |
| SRGA | 0.7494 49 | 0.5128 57 | 0.3631 52 | 0.2218 56 | 0.4497 52 | 0.2871 56 | |
| scanrefer-rj-org | 0.7345 52 | 0.4716 58 | 0.3536 58 | 0.2125 57 | 0.4390 54 | 0.2706 57 | |
| SR-GAB | 0.7016 56 | 0.5202 55 | 0.3233 65 | 0.1959 60 | 0.4081 62 | 0.2686 58 | |
| SPANet | 0.5614 66 | 0.4641 60 | 0.2800 69 | 0.2071 59 | 0.3431 70 | 0.2647 59 | |
| ScanRefer | | 0.6859 58 | 0.4353 62 | 0.3488 59 | 0.2097 58 | 0.4244 56 | 0.2603 60 |
| Dave Zhenyu Chen, Angel X. Chang, Matthias Nießner: ScanRefer: 3D Object Localization in RGB-D Scans using Natural Language. 16th European Conference on Computer Vision (ECCV), 2020 | |||||||
| scanrefer2 | 0.6340 63 | 0.4353 62 | 0.3193 66 | 0.1947 61 | 0.3898 64 | 0.2486 61 | |
| TransformerRefer | 0.6010 64 | 0.4658 59 | 0.2540 71 | 0.1730 66 | 0.3318 71 | 0.2386 62 | |
| ScanRefer Baseline | 0.6422 61 | 0.4196 64 | 0.3090 67 | 0.1832 62 | 0.3837 66 | 0.2362 63 | |
| ScanRefer-test | 0.6999 57 | 0.4361 61 | 0.3274 62 | 0.1725 67 | 0.4109 60 | 0.2316 64 | |
| ScanRefer_vanilla | 0.6488 60 | 0.4056 65 | 0.3052 68 | 0.1782 64 | 0.3823 67 | 0.2292 65 | |
| pairwisemethod | 0.5779 65 | 0.3603 66 | 0.2792 70 | 0.1746 65 | 0.3462 69 | 0.2163 66 | |
| bo3d | 0.5400 67 | 0.1550 67 | 0.3817 44 | 0.1785 63 | 0.4172 59 | 0.1732 67 | |
| Co3d3 | 0.5326 68 | 0.1369 68 | 0.3848 42 | 0.1651 68 | 0.4179 58 | 0.1588 68 | |
| Co3d2 | 0.5070 69 | 0.1195 71 | 0.3569 57 | 0.1511 69 | 0.3906 63 | 0.1440 69 | |
| test_submitt | 0.4732 71 | 0.1286 69 | 0.3626 53 | 0.1399 70 | 0.3874 65 | 0.1373 70 | |
| bo3d0 | 0.4823 70 | 0.1278 70 | 0.3271 63 | 0.1394 71 | 0.3619 68 | 0.1368 71 | |
| 3DVLP | 0.0038 72 | 0.0019 72 | 0.0049 72 | 0.0023 72 | 0.0047 72 | 0.0022 72 | |
| Co3d | 0.0000 73 | 0.0000 73 | 0.0000 73 | 0.0000 73 | 0.0000 73 | 0.0000 73 | |